

Métriques de qualité des appels
Ce que mesurent les trois scores affichés sur la page d'un appel : Call Quality, AI Relevancy et Faithfulness, et les cas où l'un d'eux n'a pas de score.
Agents vocauxChaque appel terminé est noté à son issue et les résultats figurent en haut de la page Détails de l’appel sous forme de trois jauges. Les scores sont produits par un modèle qui lit la transcription ; ils constituent une appréciation de la conversation, et non une mesure de l’audio.
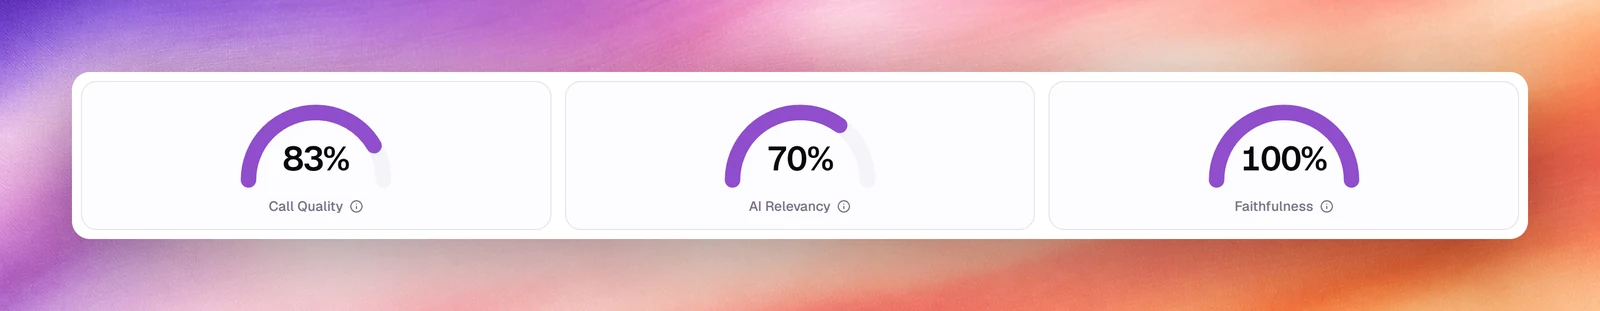
Call Quality
Un score global de 0 à 100 qui évalue le déroulement d’ensemble de la conversation, sa cohérence, son naturel et l’accomplissement de la tâche. La carte Quality assessment (évaluation de la qualité), sur la même page, en est l’explication rédigée : elle indique ce qui a bien fonctionné (respect de la tâche, étapes claires, ton courtois) et ce qui a fait baisser le score (une répétition maladroite, une formule robotique).
Servez-vous-en pour classer les appels à examiner. Une modification du prompt qui relève le niveau habituel de Call Quality sur une semaine d’appels est une modification à conserver.
Call Quality ne repose sur aucune formule. Il s’agit d’une appréciation unique portant sur l’appel entier : lisez-la comme un classement, non comme une mesure. Un 71 et un 74, c’est deux fois le même appel.
AI Relevancy
Chaque réponse de l’agent est notée individuellement, de 0 à 1, selon la façon dont elle répond à ce que l’appelant venait de dire. La jauge est la moyenne de ces scores :
où $n$ est le nombre de tours de parole de l’agent. Deux conséquences méritent d’être connues avant de lire ce chiffre.
Une moyenne masque l’endroit où se situe l’échec. Douze tours à 1,0 avec un tour à 0 donnent 92 %. Douze tours à 0,92 aussi. Le premier cas correspond à une seule réponse défaillante à corriger ; le second à un agent légèrement à côté du sujet d’un bout à l’autre, ce qui relève du prompt. La jauge ne peut pas vous dire lequel des deux : ouvrez la transcription.
Les appels courts varient fortement. Une réponse hors sujet coûte $100/n$ points : sur un appel de 4 tours, elle coûte 25, et sur un appel de 40 tours, 2,5. Comparer la pertinence d’un appel de 30 secondes à celle d’un appel de 5 minutes ne compare presque rien ; comparez plutôt les médianes sur un grand nombre d’appels de durée comparable.
Une faible pertinence associée à un Call Quality élevé est la configuration la plus courante : elle signifie que l’agent a été courtois et fluide mais n’a pas répondu à la question. Vérifiez les Tasks (tâches) dans le prompt, ainsi que la présence de l’outil ou des connaissances dont l’agent avait besoin.
Faithfulness
Indique si ce que l’agent a dit est étayé par ce qu’il a effectivement récupéré. Il s’agit d’une proportion des affirmations vérifiables de l’agent : la valeur se situe donc entre 0 et 1 et la jauge l’affiche en pourcentage :
75 % signifie qu’une affirmation sur quatre n’était étayée par aucun des documents renvoyés. C’est la définition de la métrique ; la plateforme ne publie pas la façon dont elle découpe une réponse en affirmations : considérez donc un écart de quelques points comme du bruit, et un écart de plusieurs dizaines de points comme réel.
Deux choses que cette métrique ne mesure pas. Elle ne vérifie pas si vos documents sont exacts, seulement si l’agent est resté dans leurs limites : un agent qui cite fidèlement un tarif obsolète obtient donc 100 %. Et elle ne dit rien de la recherche elle-même : si la recherche a renvoyé la mauvaise page et que l’agent a correctement résumé cette page, la faithfulness est parfaite et la réponse reste fausse.
Lorsque l’appel n’a mobilisé aucune base de connaissances, la jauge affiche un tiret au lieu d’un pourcentage et son icône d’information indique Knowledge base not used (base de connaissances non utilisée), car le dénominateur est nul. Un agent dépourvu d’outil Knowledge Base n’obtient jamais de score de faithfulness, pas plus qu’un appel au cours duquel l’agent n’a tout simplement jamais effectué de recherche.
Un score faible signifie que l’agent a dit quelque chose que les documents récupérés n’étayent pas. Lisez les lignes Used search_knowledge_base dans la transcription pour voir ce qui a été renvoyé, puis resserrez les garde-fous du prompt ou les documents eux-mêmes.
Lire les trois scores ensemble
Ces scores répondent à des questions différentes, et l’information utile se trouve généralement là où ils divergent.
| Call Quality | AI Relevancy | Faithfulness | Ce que cela signifie en général |
|---|---|---|---|
| Élevé | Élevé | Élevé | Rien à faire. |
| Élevé | Faible | indifférent | Fluide et courtois, mais sans réponse. Un problème de prompt. |
| Faible | Élevé | indifférent | Des bonnes réponses mal délivrées : répétitions, blancs, fin abrupte. |
| indifférent | indifférent | Faible | L’agent est sorti du cadre de ses documents. Les garde-fous, ou les documents. |
| indifférent | indifférent | Aucun score | Aucune base de connaissances n’a été interrogée. Ce n’est pas un échec. |
Où apparaissent ces scores
- Les jauges sur la page de chaque appel, avec l’explication rédigée de Call Quality dans la carte Quality assessment lorsque la notation en a produit une.
- Overall Success Rate (taux de réussite global) et les onglets Success Rate (taux de réussite) du Dashboard résument l’accomplissement des tâches, pas ces scores.
- Ces scores ne sont pas proposés comme colonnes dans les Call Logs.